세 가지 기초개념
Languages(언어), Grammers(문법), Automata(오토마타)
Languages(언어)
언어를 이해하기 위해서 여러가지를 살펴봐야한다.
Symbol(기호): 한글에서 자음과 모음, 10진수에서 0~9 숫자를 생각하면 된다. 언어를 이루는 가장 기본적인 요소.
Alphabet(알파벳): 영어의 알파벳은 알파벳의 한 종류라고 생각해야한다. 하나 이상의 심벌들의 유한 집합(공집합x)이다. 보통 Σ로 표현한다.
String(문자열): 알파벳에 속한 심벌들의 유한길이의 순서열. 개개의 심벌들로부터 만들어짐.
ex) if alphabet is Σ = {a, b}, abab or aaabba is String about alphabet Σ
문자열의 접합 : 문자열 w의 오른쪽에 문자열 v를 이어붙여 얻어지는 문자열
w = a1a2...an
v = b1b2...bn
접합 wv = a1a2...anb1b2...bn
역 문자열: 문자열 역순
길이: 문자열 w의 길이는 ∣w∣로 표기한다. ∣uv∣ = ∣u∣ + ∣v∣가 성립한다.
빈문자열: λ로 표기한다 ∣λ∣ = 0. ∣λ∣w = w∣λ∣ = w
부문자열(substring): 문자열 w내에 존재하는 연속적인 문자들의 문자열.
전위부(prefix) : w = vu 라고 할때, v를 말한다.
후위부(suffix) : w = vu 라고 할때, u를 말한다.
w = abbab인 경우,
{λ, a, ab, abb, abba, abbab}는 v의 모든 prefix들의 집합이다.
{abbab, bbab, bab, ab, b}는 u의 모든 suffix의 집합이다.
Σ* = 알파벳 Σ에 대해 Σ에 속한 알파벳은 0개이상 접합해 얻어지는 모든 문자열들의 집합(당연히 λ도 포함된다)
Σ+ = Σ에서 λ을 제외한 집합, Σ - λ = Σ+
Σ는 유한집합이지만, Σ*, Σ+는 문자열 길이에 제한이 없기 때문에 무한집합이다.
이제 언어에 대해 이해하자.
언어: 일반적으로 Σ*의 부분집합이다.
문장: 임의의 언어 L에 속하는 문자열을 언어 L의 문장이라 한다.
주어진 알파벳 Σ에 대한 문자열들의 집합은 모두 언어라고 생각할 수 있으며, 매우 광범위하다.
예시를 통해 언어에 대해 더 이해해보자.
Σ = {a, b}이면, Σ* = {λ, a, b, aa, ab, ba, bb, aab, ...............} 이다.
언어는 Σ*의 부분집합이므로 {a, b, aa, ab}는 Σ에 대한 언어다.
이 집합은 갯수가 유한하므로 유한 언어라고 한다.
이번에는 집합 L을 L = { anbn: n >= 0 } 라고 하자.
이 집합은 무한하게 문자열을 가지므로, 무한 언어라고 한다
언어도 집합이므로, 집합 연산(합집합, 교집합, 차집합)이 정의된다.
언어의 여집합: 여집합은 Σ을 기준으로 정의된다. 즉 Lc = Σ - L 이다.
언어의 역: 어떤 언어에 속하는 모든 문자열들의 역 문자열들의 집합. LR = { wR : w ∈ L }
언어의 접합: 언어 L1과 L2의 접합은 두 언어의 원소를 접합에 얻을 수 있는 모든 문자열들의 집합.
L1L2 = { xy: x ∈ L1, y ∈ L2 }.
언어 L을 n번 접합해서 만들어지는 언어 = Ln
스타-폐포(star-closure): L* = L0 ∪ L1 ∪ L2 ∪ ...
양성-폐포(positive-closure): L+ = L1 ∪ L2 ∪ ...
예시)
언어 L을 L = { anbn: n >= 0 } 라고하자.
L을 두 번 접합한 언어를 L2라고 하자 했다.
즉 L2 = { anbnambm: n >= 0, m >= 0 }이고,
LR = { bnan: n >= 0 } 이다.
언어 Lc, L*는 집합으로 표현하기 어려운 제약점이 존재한다.
Grammers(문법)
언어에 대해 수학적으로 연구하기 위해서는 언어를 묘사할 수 있어야한다.
하지만 일상의 언어들은 부정확하고 모호하고, 비형식적이다.
집합 표기법으로 언어를 나타낼 수 있지만, 제약점이 존재함을 확인했다.
때문에 언어 정의 기법을 공부할 것이고, 이 중 가장 강력한 기법인 문법에 대해 공부한다.
문법 G는 네 원소 쌍으로 정의된다.
G = (V, T, S, P), V와 T는 공집합이 아니며, 서로소다.
V : 변수라고 불리는 객체들의 유한집합
T : 단말 심벌이라 불리는 객체들의 유한집합
S : V에 속하는 특별한 심벌, 시작변수라 부름
P : 생성규칙들의 유한집합
생성 규칙에 대해 먼저 살펴보면,
모든 생성규칙은 x → y의 형태를 갖는다.
단, x ∈ ( V ∪ T )+, y ∈ ( V ∪ T )*
문자열 w를 w = uxv 라고 정의하면,
이 문자열에 생성규칙 x → y 가 적용될 수 있으며, x를 y로 대체하기 위해 생성규칙을 사용해
문자열 z = xyv를 얻을 수 있다.
이를 w ⇒ z 로 표현하고, 'w가 z를 유도한다' 또는 'z가 w로부터 유도된다' 라고 말한다.
유도가 연속적으로 일어날 수 있으며, a ⇒ b ⇒ c ⇒ d ⇒ ... ⇒ z 일 때
a ⇒* z 로 나타낸다. (사진 참고)

*는 z가 a로부터 유도될 때, 명기되지 않은 수의 단계가 있을 수 있음을 의미한다.(아닐 수도 있음)
생성 규칙을 서로 다른 순서로 적용함으로써, 문법을 통해 많은 문자열들을 생성할 수 있다.
이러한 모든 단말 문자열들의 집합을 주어진 문법에 의해 생성, 정의되는 언어라 한다.
이제 언어 L(G)는 문법 G = (V, T, S, P)가 주어질 때 다음과 같이 정의된다:
L(G) = { w ∈ T*: S ⇒* w }
유도 : w ∈ L(G)이면 S ⇒ w1 ⇒ w2 ⇒ ... ⇒ w 를 문장 w에 대한 유도라고 한다.
문장형태 : 유도의 S, w1, w2, ... , w 등을 이 유도에서의 문장 형태라고한다.
예시)
문법 G = ( {S}, {a, b}, S, P = {S → aSb, S → λ} ) 라 하자.
S ⇒ aSb ⇒ aaSbb ⇒ aabb 이러한 유도가 가능하다.
이는 S ⇒* aabb로 나타낼 수 있다.
aabb ∈ L(G), aaSbb는 문장형태다.
L(G)를 문자열에 대한 집합 자체로 나타내기 어려울 수 있지만,
짐작상 L(G) = { anbn: n >= 0 } 로 나타낼 수 있다.
오토마타
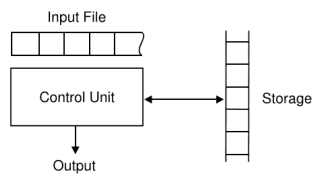
디지털 컴퓨터에 대한 추상적 모델.
이산시간 단위로 운영됨을 가정함.
결정적 오토마타와 비결정적 오토마타로 나뉨.
각 오토마타의 이후의 행동을 유일하게 결정할 수 있다면 결정적 오토마타고,
여러가지 이동이 가능해서 이후의 행동의 집합을 예측할 수 있다면 비결정적 오토마타다.
오토마타의 출력이 단순히 'YES' or 'NO' 라면 인식기라고 부름.
인식기보다 더 일반적으로 임의의 문자열을 출력할 수 있다면 변환기라고 부름.
필수 기능 :
입력파일
-
주어진 알파벳에 대한 스트링이 셀 단위로 입력됨
-
오토마타는 읽을 수 있지만 변경 불가능.
-
각 셀은 하나의 심벌을 저장할 수 있음.
-
왼쪽에서 오른쪽으로 한 심벌씩 읽음.
-
end-of-file 조건을 감지해 문자열의 마지막을 인지할 수 있음.
기억장소
- 무한개의 셀들로 구성되어 각 셀은 주어진 알파벳 내의 한 심벌을 저장함.
제어장치
- 유한개의 내부 상태들 중 한 상태에 있을 수 있음, 미리 정해진 규칙에 따라 상태를 바꿀 수 있음.