2편에서 집 서버에 문제가 생기면 폰으로 알림이 오게 했다. 그런데 군대에서는 알림을 봐도 고칠 시간이 없다. 그래서 알림이 오면 AI가 서버에 들어가서 고치고, 결과만 폰으로 보내게 만들었다.
AI가 고치려면 먼저 이상을 빠짐없이 알아채야 한다. 감시를 내 감으로 짜면 빈틈이 생길 것 같아서, 서버 모니터링을 업계에서는 어떻게 하는지부터 찾아봤다. 어느 자료에서나 비슷하게 나오는 원칙이 세 가지 있었다.
가장 기본은 안과 밖을 둘 다 보는 것이다. 구글 SRE 책의 모니터링 장은 시스템 안의 지표를 보는 화이트박스 모니터링과, 사용자가 보는 그대로 바깥에서 확인하는 블랙박스 모니터링을 나눈다. 화이트박스는 곧 터질 문제를 미리 잡고, 블랙박스는 지금 실제로 망가진 것을 잡는다. 구글은 화이트박스를 주로 쓰고, 블랙박스는 적지만 꼭 필요한 곳에 쓴다고 한다.
감시가 살아 있는지도 따로 확인해야 한다. 감시하는 쪽이 멈추면 알림도 같이 끊기는데, 알림이 안 오는 건 괜찮다는 뜻처럼 보인다. 그래서 주기적으로 신호를 보내고, 신호가 끊기면 알리는 하트비트를 쓴다. Healthchecks.io 문서는 이 방식으로 정전이나 하드웨어 고장처럼 기계 전체가 꺼진 경우까지 잡는다고 설명한다. Prometheus Operator의 Watchdog 알림도 같은 구조다. 일부러 늘 울리게 해 두고, 그 알림이 끊기면 바깥 시스템이 알아챈다.
그리고 감시는 감시받는 쪽과 다른 곳에 둔다. Prometheus 교육 자료는 자기 자신을 감시하면 고장 날 때 감시도 같이 고장 나서 깨지기 쉽다고 설명한다. 그래서 감시만 맡는 서버를 따로 두라고 권한다.
이 셋에 맞춰 감시를 세 가지로 나눴다.
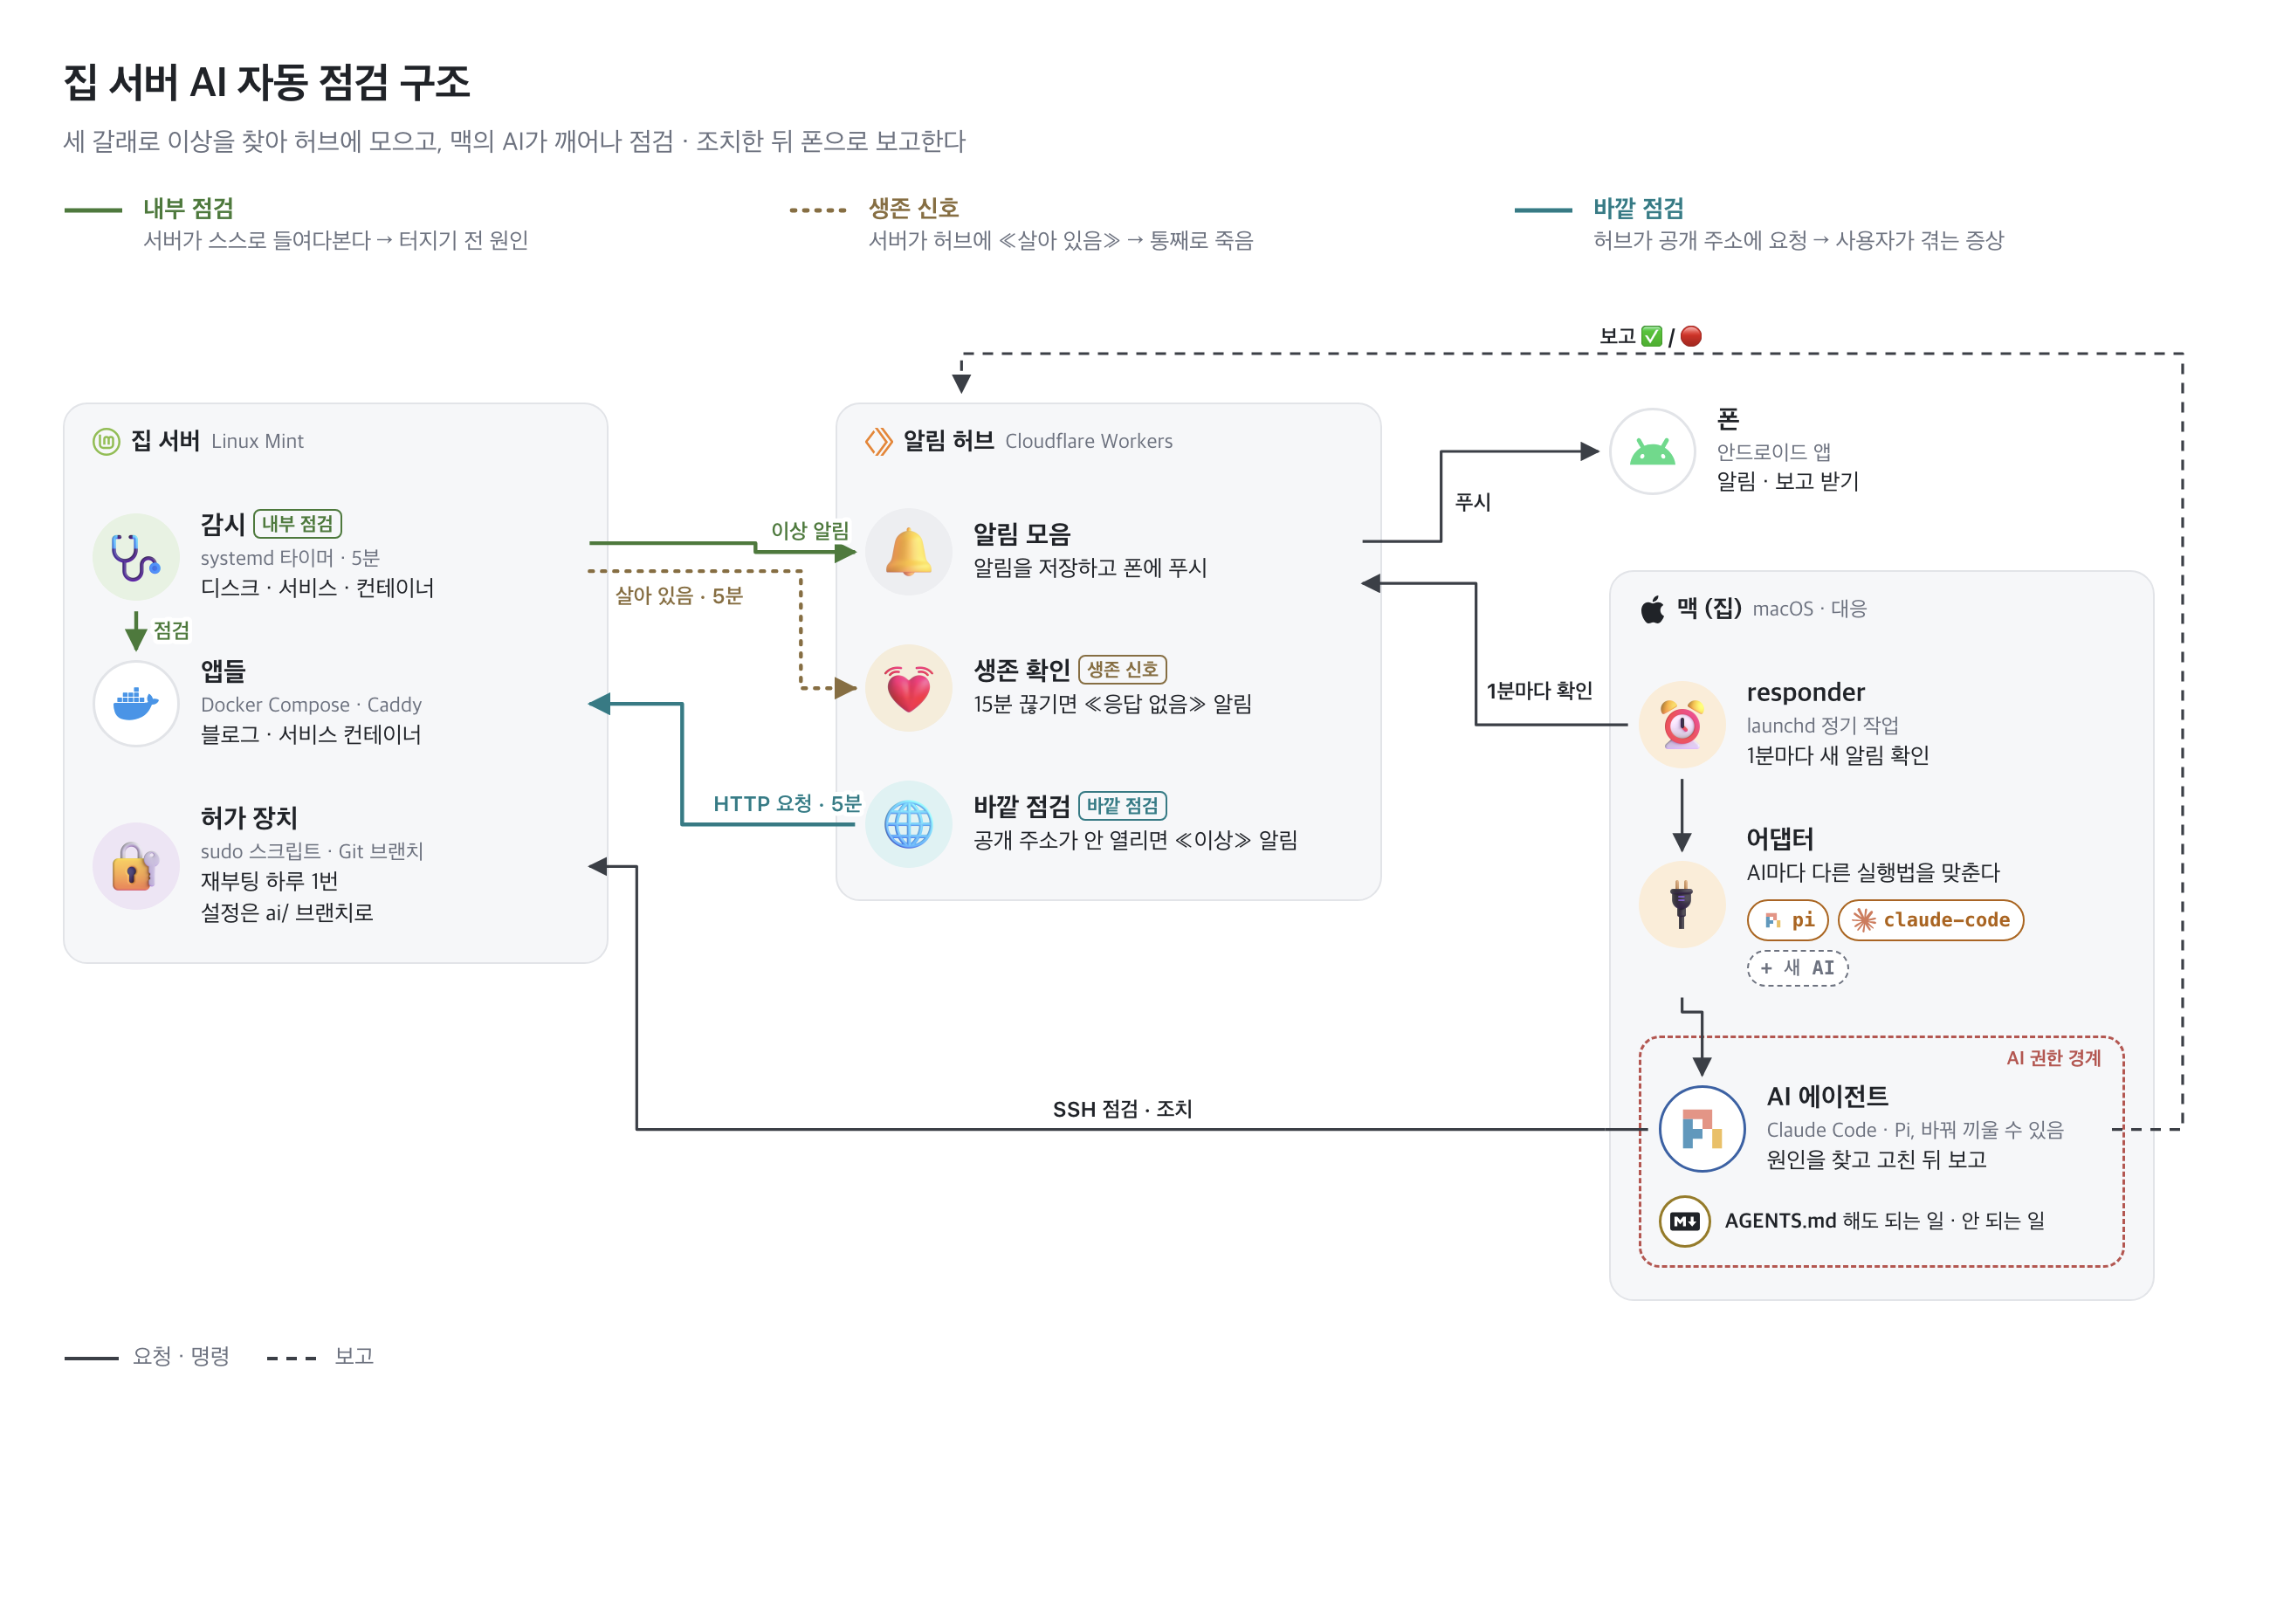
내부 점검
화이트박스 쪽이다. 서버 안에서 systemd 타이머가 5분마다 감시 스크립트를 돌린다. 디스크가 85% 넘게 찼는지, 남은 메모리가 1GB 아래인지, 주요 서비스와 컨테이너가 떠 있는지 본다. SSD 상태, 온도, 팬 속도, 랜 속도도 본다. 문제가 새로 생기거나 풀릴 때만 허브로 알림을 보낸다.
컨테이너는 종료 코드가 아니라 재시작 정책으로 판단한다. unless-stopped나 always로 띄운 컨테이너는 늘 떠 있어야 하니까, 어떻게 꺼졌든 이상으로 본다.
생존 신호
하트비트다. 같은 감시 스크립트가 5분마다 허브에 살아 있다는 신호를 보낸다. 15분 동안 안 오면 허브가 응답 없음 알림을 보낸다. 정전, 인터넷 끊김, 서버 멈춤처럼 서버가 스스로 알릴 수 없는 상황을 잡는다. 감시 스크립트가 멈춘 것도 같이 잡힌다.
바깥 점검
블랙박스 쪽이다. 허브가 5분마다 공개 주소 10개를 사용자처럼 직접 열어 본다. 도메인, 인증서, 공유기, Caddy가 틀어지면 서버 안에서는 멀쩡해 보여도 사용자는 사이트를 못 연다. 그런 문제를 여기서 잡는다. 실패하면 5초 뒤에 한 번 더 열어 보고, 안 열리는 주소가 생기거나 다시 열릴 때만 알린다.
생존 신호는 서버가 보내고 허브가 기다리는 쪽이고, 바깥 점검은 허브가 서버를 찾아가는 쪽이다. 허브는 Cloudflare Workers에서 돌아서 집 서버와 같이 죽지 않는다.
알림이 오면
고치는 AI도 같은 이유로 서버가 아니라 집에 있는 맥에서 돌린다. 맥에서는 launchd가 1분마다 허브에 새 알림을 물어본다. 재부팅 직후처럼 알림이 몰려올 때가 있어서, 마지막 알림 뒤 90초를 기다렸다가 한꺼번에 넘긴다. 한 시간에 돌릴 수 있는 횟수도 정해 뒀고, 넘으면 사람이 보라고 알림만 보낸다.
AI를 실행하는 부분은 AI마다 파일 하나로 나눠 뒀다. 지금은 Claude Code와 Pi가 있고, 다른 AI를 쓰게 되면 파일만 하나 더 만들면 된다. AI는 SSH로 서버에 들어가 로그를 보고 원인을 찾는다. 할 수 있는 일은 서버 레포의 AGENTS.md에 적어 뒀다. 꺼진 컨테이너를 다시 켜는 건 바로 하고, 데이터는 지우지 않는다. 재부팅은 하루 한 번까지만 된다. 고친 뒤에는 같은 확인을 다시 해서 풀렸는지 보고, 결과를 폰으로 보낸다.
시험
세 감시가 실제로 잡는지 일부러 고장을 내 봤다.
먼저 블로그 댓글 서버 컨테이너를 docker stop으로 멈췄다. 처음에는 20분을 기다려도 알림이 오지 않았다. docker stop으로 멈추면 종료 코드가 0인데, 감시 스크립트가 종료 코드 0으로 꺼진 컨테이너를 정상으로 쳤기 때문이다. Docker도 사람이 멈춘 컨테이너는 다시 켜 주지 않는다. 위에 적은 재시작 정책 판단은 이걸 보고 고친 것이다.
고친 뒤 다시 멈추니 4분 만에 내부 점검이, 5분 만에 바깥 점검이 알렸다. AI는 컨테이너를 다시 켜고 서버 안과 바깥에서 둘 다 열리는지 확인했다. 멈춘 지 9분 만에 복구 보고가 폰으로 왔다.
서버 네트워크도 30분 동안 끊어 봤다. 정전이나 회선 장애처럼 서버가 아무것도 보낼 수 없는 상황이다. 13분 뒤 허브가 응답 없음 알림을 보냈다. AI는 서버에 접속이 안 되는 걸 확인하고 원격으로는 손댈 수 없다고 보고했다. 30분 뒤 네트워크가 돌아오자 복구 알림이 왔다.